


On optimise un graphe de connaissances en travaillant à la fois sur sa structure, ses index, ses parcours et ses requêtes. Pour l’IA d’entreprise, l’enjeu est aussi de fournir un contexte plus précis, sans faire exploser les temps de réponse ni les coûts.
Pourquoi les bases relationnelles atteignent-elles leurs limites ?
Les bases relationnelles atteignent leurs limites quand une question métier oblige à relier beaucoup de données dispersées, à travers plusieurs systèmes et plusieurs niveaux de relations. Ce n’est pas une limite absolue : c’est souvent le coût de ces rapprochements qui devient difficile à maîtriser.
Pour comprendre les liens entre fournisseurs, clients, transactions et contrats, il faut parfois combiner des données issues de plusieurs applications. Dans une base relationnelle, ces informations sont réparties dans des tables. On les rapproche avec des jointures SQL, c’est-à-dire des opérations qui associent des lignes de différentes tables à partir de champs communs.
Une requête peut alors enchaîner de nombreuses jointures : fournisseurs vers contrats, contrats vers transactions, transactions vers clients. À mesure que les volumes augmentent, ces requêtes peuvent devenir plus complexes à concevoir et à maintenir. Leur exécution peut aussi ralentir, notamment quand les tables sont grandes ou que les relations sont difficiles à anticiper. Le calcul mobilise alors davantage de ressources, ce qui peut faire grimper les coûts.
Dans un graphe de connaissances, les relations sont des éléments à part entière du modèle. Un fournisseur, un contrat et une transaction sont représentés par des nœuds, reliés par des liens que l’on peut parcourir directement. Le modèle conserve ainsi le contexte métier : on ne voit pas seulement qu’un contrat contient une référence client, mais aussi qu’il relie un fournisseur à un client et à des transactions précises.
Ça ne signifie pas qu’un graphe remplace toujours une base relationnelle. Pour des données tabulaires et des opérations simples, une base relationnelle reste souvent très adaptée. Dans les projets que j’accompagne, le choix dépend surtout des questions à traiter et du coût réel des rapprochements.
Un graphe facilite certains parcours, mais il peut lui aussi devenir lent ou coûteux s’il est mal conçu. Il faut donc optimiser le graphe lui-même : ses données, ses relations et la manière dont on les parcourt.
Que signifie optimiser un graphe de connaissances ?
Optimiser un graphe de connaissances, c’est améliorer en continu ses performances, son évolutivité et son utilité, sur l’ensemble de son cycle de vie. Je ne réduis pas ce travail au réglage de la base de données. Il peut aussi concerner l’architecture des données, la conception du graphe, le calcul distribué — qui répartit les traitements sur plusieurs machines —, l’apprentissage automatique et l’intégration de l’IA générative.
Le graphe évolue avec les données et les usages. Mais chaque ajout d’entité ou de relation peut aussi rendre certains traitements plus coûteux. Les parcours entre les nœuds s’allongent, les espaces de recherche s’élargissent et les requêtes doivent parfois explorer davantage de chemins possibles. À grande échelle, les traitements distribués deviennent eux aussi plus exigeants : il faut déplacer et coordonner les données entre plusieurs systèmes.
Optimiser, c’est donc trouver un équilibre entre la richesse du graphe et sa capacité à répondre rapidement à des questions utiles. Un graphe très détaillé n’est pas automatiquement un bon graphe. Si sa structure complique les requêtes ou si ses données ne servent aucun usage concret, sa valeur reste limitée.
Une prévision attribuée à Gartner dans les éléments disponibles estimait que les technologies de graphes soutiendraient 80 % des innovations en données et en analytique d’ici 2026, contre 10 % en 2021. Il s’agit bien d’une prévision, pas d’un résultat observé. Elle illustre néanmoins l’importance croissante accordée aux graphes pour relier des données et en tirer des usages.
Dans la pratique, l’optimisation se traduit par des choix concrets :
- Structurer les entités et les relations en fonction des questions à résoudre.
- Réduire les parcours inutiles et améliorer les requêtes les plus fréquentes.
- Adapter l’architecture aux volumes de données et aux traitements attendus.
- Vérifier régulièrement que le graphe reste fiable, rapide et utile.
Le chapitre suivant aborde ces leviers opérationnels et la manière de les mobiliser selon les besoins du graphe.
Quels leviers améliorent les performances du graphe ?
L’optimisation d’un graphe de connaissances combine plusieurs leviers, à choisir selon les besoins du graphe. Je commence par identifier ce qui freine réellement les usages : des requêtes lentes, une croissance difficile à absorber, une consommation excessive de ressources ou un contexte métier devenu moins fiable.
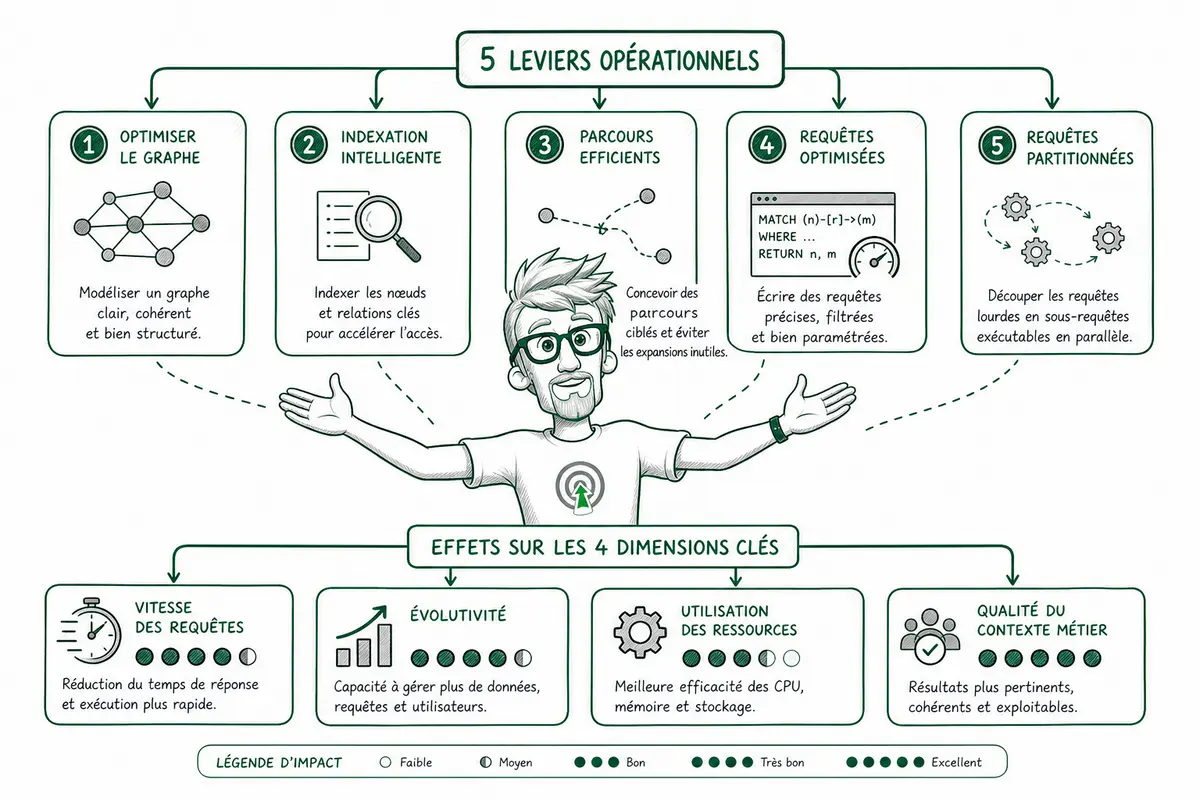
Le stockage et l’indexation influencent directement la vitesse d’accès aux données. Une organisation adaptée aux types de requêtes attendues peut accélérer les recherches et éviter de mobiliser inutilement des ressources. L’indexation, qui facilite la localisation des éléments recherchés, doit cependant rester cohérente avec les usages : trop d’index peut aussi alourdir le traitement des mises à jour.
L’optimisation des parcours de graphe consiste à limiter les explorations inutiles entre les entités et leurs relations. C’est particulièrement important quand une requête suit plusieurs liens. Un parcours mieux ciblé peut réduire le temps de réponse et la quantité de données examinées.
La planification des requêtes détermine dans quel ordre les opérations sont exécutées. Elle peut éviter des traitements coûteux lorsqu’un filtre simple permet d’écarter rapidement une grande partie des données. Le gain dépend toutefois de la forme des requêtes et de la structure du graphe.
Le partitionnement répartit les données en ensembles plus faciles à traiter. Il peut soutenir l’évolutivité, c’est-à-dire la capacité du système à accompagner la croissance du volume de données ou du nombre d’usages. Il faut préserver les liens entre les partitions pour ne pas compliquer les parcours.
La résolution d’entités rapproche les enregistrements qui désignent une même personne, une même organisation ou un même objet. Elle réduit les doublons et préserve la qualité du contexte métier. Sans cette cohérence, un graphe peut répondre vite tout en donnant une vision fragmentée ou trompeuse.
Ces leviers répondent à des objectifs liés, mais pas toujours identiques :
- Accélérer les requêtes grâce à un accès et à des parcours mieux ciblés.
- Soutenir l’évolutivité en organisant les données pour accompagner leur croissance.
- Mieux utiliser les ressources en limitant les traitements et explorations inutiles.
- Préserver le contexte métier en maintenant des entités cohérentes et des relations pertinentes.
Les mêmes principes comptent pour les applications d’IA, notamment GraphRAG, qui combine un graphe de connaissances et la génération augmentée par récupération. La qualité du contexte fourni au modèle dépend autant de la pertinence des données et des relations que de la rapidité avec laquelle elles sont retrouvées.
Comment GraphRAG améliore-t-il le contexte de l’IA ?
GraphRAG s’appuie sur un graphe de connaissances pour récupérer un contexte plus précis pour les applications d’IA. Le graphe relie des entités et leurs relations, ce qui aide le système à retrouver non seulement des informations pertinentes, mais aussi les liens qui les rendent utiles. J’y vois un intérêt concret quand une question dépend de plusieurs faits dispersés ou de relations entre des documents.
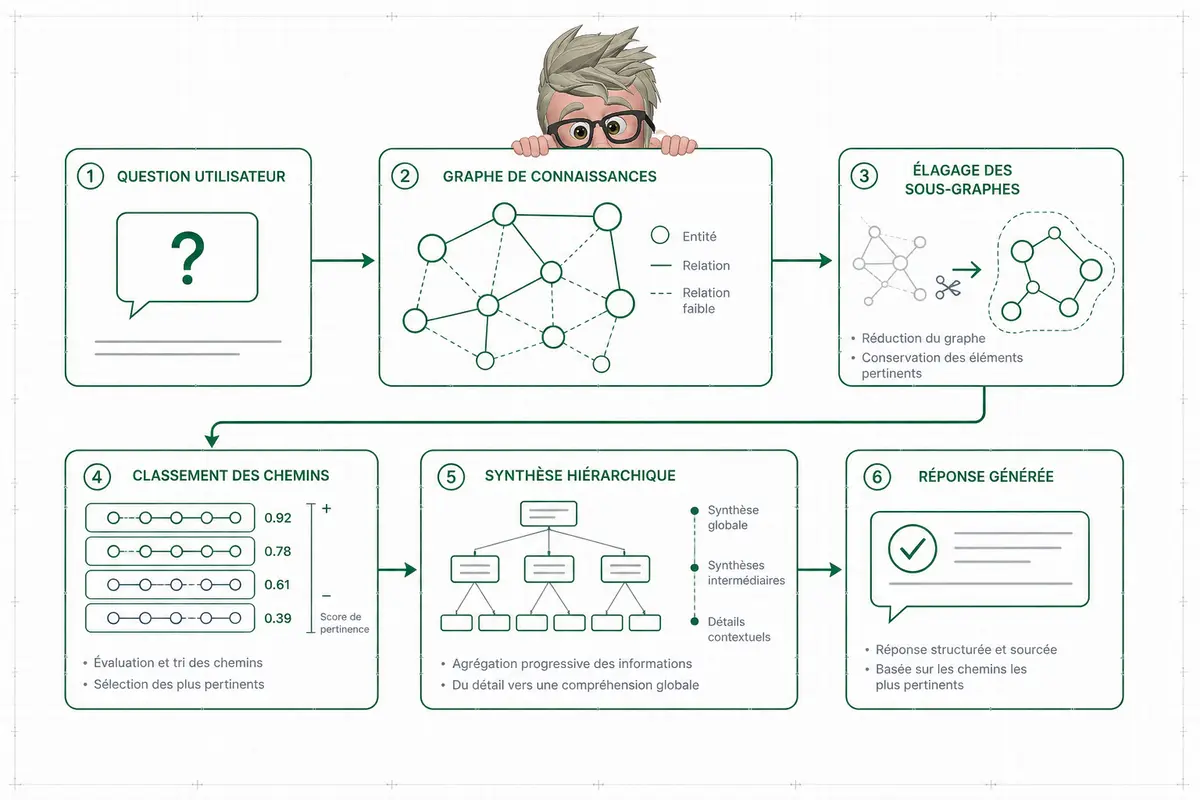
Au lieu d’envoyer au modèle un grand volume de passages similaires, GraphRAG peut sélectionner et organiser les informations nécessaires. Il combine notamment ces méthodes :
- Élagage de sous-graphes : Le système conserve la partie du graphe utile à la question et écarte les branches peu pertinentes. Le contexte transmis au modèle est ainsi plus ciblé.
- Classement des chemins : Il classe les chaînes de relations reliant les éléments utiles. Un chemin pertinent peut, par exemple, montrer comment une décision est liée à un projet, puis à un résultat.
- Synthèse hiérarchique : Il résume les informations à plusieurs niveaux, des détails locaux jusqu’à une vue d’ensemble. Le modèle peut alors répondre à une question précise sans perdre le contexte général.
Ces méthodes peuvent limiter les hallucinations, c’est-à-dire les réponses plausibles mais inexactes, en ancrant davantage la génération dans des informations reliées et sélectionnées. Elles peuvent aussi réduire l’utilisation de jetons, l’unité de texte facturée ou limitée par de nombreux modèles. Les liens récupérés rendent enfin le raisonnement plus traçable et transparent : on peut examiner les éléments et les relations qui ont contribué à la réponse. Ça ne rend pas automatiquement chaque réponse exacte, mais ça facilite sa vérification.
Des résultats rapportés évoquent une réduction de 6 % des hallucinations et une baisse pouvant atteindre 80 % de l’utilisation de jetons par rapport au RAG conventionnel, une méthode qui récupère des passages pertinents avant de générer une réponse. Les conditions de comparaison ne sont pas détaillées ici : ces chiffres ne précisent pas, à eux seuls, les tâches, les modèles ou les mesures utilisés. Ce ne sont donc pas des garanties universelles.
Dans une application réelle, la qualité du contexte influe directement sur les coûts, la rapidité et la fiabilité. Un graphe bien conçu aide à améliorer ces trois aspects ; un graphe incomplet ou mal entretenu peut produire l’effet inverse.
Votre graphe est-il optimisé pour les usages qui comptent ?
Un graphe de connaissances représente directement les liens métier que des architectures relationnelles doivent parfois reconstruire par de nombreuses jointures. Mais sa seule présence ne garantit ni rapidité ni passage à l’échelle. L’optimisation doit rester continue et couvrir la conception, les index, les parcours, la planification des requêtes, le partitionnement et la résolution d’entités. Pour GraphRAG, l’élagage, le classement des chemins et la synthèse hiérarchique peuvent aider à mieux cibler le contexte fourni à l’IA. Les gains annoncés sur les hallucinations et les jetons sont à interpréter selon leur contexte, pas comme des promesses. Le bénéfice pour vous : des applications mieux contextualisées, plus traçables et potentiellement moins coûteuses.
FAQ
- Qu’est-ce que l’optimisation d’un graphe de connaissances ?
C’est un travail continu pour améliorer les performances, l’évolutivité et l’utilité du graphe. Il peut concerner sa conception, son stockage, ses index, ses parcours et ses requêtes. - Pourquoi utiliser un graphe plutôt qu’une base relationnelle ?
Un graphe représente les relations comme des éléments de première classe. Il peut ainsi préserver le contexte métier et éviter de reconstruire certaines relations à travers de nombreuses jointures SQL. Le choix dépend toutefois des besoins. - Quels sont les principaux leviers d’optimisation ?
Les leviers cités incluent le stockage et l’indexation, les parcours de graphe, la planification des requêtes, le partitionnement et la résolution d’entités. - Comment l’optimisation aide-t-elle les applications GraphRAG ?
L’élagage de sous-graphes, le classement des chemins et la synthèse hiérarchique peuvent aider à récupérer un contexte plus précis, à limiter les hallucinations et à réduire l’utilisation de jetons. - Les gains annoncés pour GraphRAG sont-ils garantis ?
Non. Les chiffres rapportés évoquent une réduction de 6 % des hallucinations et une baisse pouvant atteindre 80 % de l’utilisation de jetons face au RAG conventionnel. Les conditions de comparaison ne sont pas détaillées ; ces valeurs ne constituent donc pas une garantie universelle.
A propos de l’auteur
Je suis Franck Scandolera, expert en data, IA et automatisation. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne les entreprises sur leurs architectures data, l’Analytics Engineering, l’intégration de l’IA et l’automatisation, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Expert et formateur en Tracking avancé, Analytics Engineering et Automatisation IA (n8n, Make) ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.