


Relier les résultats CRM à l’analytics et aux Ads permet de rapprocher l’activité du site de la valeur commerciale. Je détaille comment cadrer les événements, cartographier les champs, préserver consentement et attribution, puis tester les flux avec des contrôles vérifiables.
Quels résultats CRM faut-il suivre ?
Je ne remonte pas chaque mise à jour du CRM vers l’analytics ou les Ads. Je transmets les événements qui prouvent une progression commerciale réelle, avec des critères stables, une date et un responsable.
Je définis d’abord les étapes du cycle de vie et les transitions autorisées. Un parcours courant est : lead créé → lead qualifié → opportunité créée → gagnée ou perdue. Chaque passage doit respecter un critère explicite. Par exemple, un lead ne devient qualifié qu’après validation des critères d’adéquation et d’intention ; une opportunité n’est créée qu’avec un montant estimé et une date de clôture. Un événement « gagné » ne peut pas être envoyé si l’opportunité n’a pas d’identifiant CRM et de date de clôture. Les retours en arrière, réouvertures et annulations doivent être définis séparément, pas déduits d’un changement de statut.
Pour chaque événement, je documente quatre éléments : la preuve observable dans le CRM, le responsable métier, les dépendances et les champs transmis. Cette précision évite d’optimiser les campagnes sur des statuts saisis sans preuve ou sur des doublons.
- Lead qualifié : preuve dans les critères de qualification ; responsable commercial ; dépend du lead créé et de son identifiant ; champs : date, source, consentement et identifiant.
- Opportunité créée : preuve d’une opportunité enregistrée ; responsable commercial ; dépend du lead qualifié ; champs : identifiants du lead et de l’opportunité, montant, devise, date prévue.
- Vente gagnée : preuve du statut gagné et de la date de clôture ; responsable commercial ou finance ; dépend de l’opportunité ; champs : valeur réelle, devise, identifiants et date. Les identifiants publicitaires, comme le GCLID, ne sont transmis que s’ils sont disponibles et que le consentement le permet.
Avant toute modification, je conserve une référence datée de l’existant : événements, volumes, règles, champs et destinations. Je formalise ensuite la spécification dans un document partagé, avec un propriétaire et un historique des changements. Je teste sur un périmètre limité — une étape, une source ou une campagne — pour vérifier les données et les conversions avant extension. Les écarts sont alors traçables, au lieu de contaminer tous les rapports.
| Événement | Preuve observable | Responsable | Dépendances et champs clés |
| Lead qualifié | Critères validés dans le CRM | Commercial | Lead existant, date, source, consentement, identifiant |
| Opportunité créée | Enregistrement CRM avec montant et clôture prévue | Commercial | Lead qualifié, identifiants, valeur, devise, date |
| Vente gagnée | Statut gagné et clôture datée | Commercial ou finance | Opportunité existante, valeur réelle, devise, identifiants publicitaires autorisés |
Comment cartographier les identifiants et les flux ?
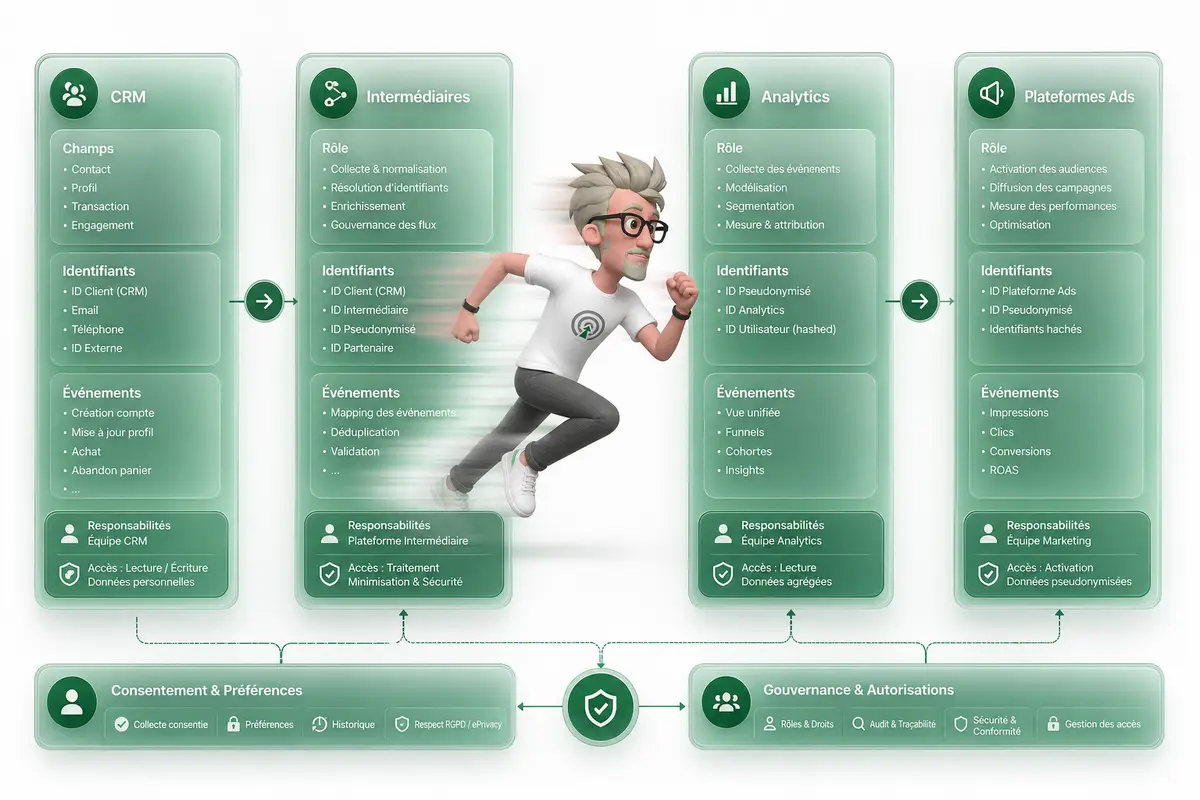
Je cartographie chaque identifiant et chaque événement depuis sa source jusqu’à sa destination, du point de collecte dans le CRM à son usage dans l’analytics ou les Ads. La cartographie doit montrer ce qui circule, par où, sous quelle responsabilité et avec quelle autorisation.
| Élément | À documenter |
| Champ | Nom, format, définition et source faisant autorité |
| Flux | Système émetteur, intermédiaires, destination et fréquence |
| Responsabilité | Équipe propriétaire de l’infrastructure et équipe responsable de la sécurité |
| Identifiants | Identifiants autorisés, finalité d’usage et règles de conservation |
| Événement | Événement métier, déclencheur et preuve de réception de bout en bout |
Je vérifie ensuite les dépendances en amont et en aval. Un champ repris par un connecteur, une règle de déduplication ou une audience publicitaire peut être modifié sans que le CRM l’indique clairement. Pour chaque valeur, je désigne une source faisant autorité : le CRM pour le statut client, par exemple, ou la plateforme publicitaire pour l’identifiant de clic qu’elle génère.
Les identifiants de clic ou de corrélation approuvés — comme un gclid, identifiant de clic Google Ads, ou un identifiant interne de rapprochement — doivent être capturés dans l’environnement sûr le plus restreint possible. Je limite l’accès, je contrôle la durée de conservation et je ne les propage qu’aux systèmes autorisés. Je modifie une seule couche logique à la fois, puis je vérifie la valeur à chaque frontière du flux. Ça permet d’isoler une perte ou une transformation sans perturber tout le parcours.
Un événement n’est suivable de bout en bout que si son identifiant reste exploitable entre la collecte, le CRM, l’analytics et l’activation Ads, dans le respect du consentement et des règles applicables. Si une donnée manque, je corrige la collecte ou le contrat d’interface. Je ne la reconstruis jamais à partir d’un libellé visible, d’une URL affichée ou d’un autre élément de présentation : ces éléments ne sont pas une source fiable.
Comment fiabiliser les données transmises ?
Je fiabilise les données en comparant chaque champ à la source et à la destination, puis en vérifiant les valeurs réellement transmises. Un tableau de correspondance documente les transformations, les champs obligatoires et les règles de rejet. Les formats disponibles et les exigences diffèrent selon les CRM, les outils analytics et les plateformes Ads : je les valide dans la documentation et sur un flux de test, sans supposer qu’un champ est accepté partout.
Je contrôle les mêmes dimensions aux deux extrémités :
| Dimension | Contrôle |
| Noms et types | Correspondance des noms, types attendus, nullabilité et transformations de format. |
| Portée et temporalité | Événement, contact ou compte ; moment de création, mise à jour et période de validité. |
| Identifiants et horodatages | Identifiant stable, règles de déduplication, fuseau horaire et unité de temps. |
| Devise et valeurs | Devise explicite, unité cohérente, valeurs autorisées et limites plausibles. |
| Champs vides | Différence entre champ absent, valeur nulle, chaîne vide et valeur par défaut. |
L’inspection visuelle d’un échantillon ne suffit pas. Je la complète par une trace des requêtes ou des enregistrements transmis, puis je compare le payload sortant à la réponse ou à l’enregistrement reçu. Je vérifie les erreurs, les champs ignorés, les conversions et les doublons. Les traces doivent être accessibles pour le diagnostic, mais protégées et expurgées des données sensibles qui ne sont pas nécessaires.
La minimisation et le consentement se conçoivent dès le départ, pas après le lancement. Je supprime les champs inutiles, conserve l’état du consentement avec sa portée et son horodatage, puis applique cette règle avant chaque transmission. Seuls les champs autorisés partent vers la destination concernée. Si le consentement est absent, retiré ou incompatible avec la finalité, le flux doit bloquer ou exclure les données selon les règles applicables.
Quelle architecture utiliser pour les transferts ?
Je fais transiter les événements par un point de terminaison first-party, hébergé sur un domaine que l’entreprise contrôle, puis je les route vers l’analytics et les plateformes Ads. Cette architecture centralise les règles de collecte et évite de multiplier les connexions directes depuis le site ou l’application.
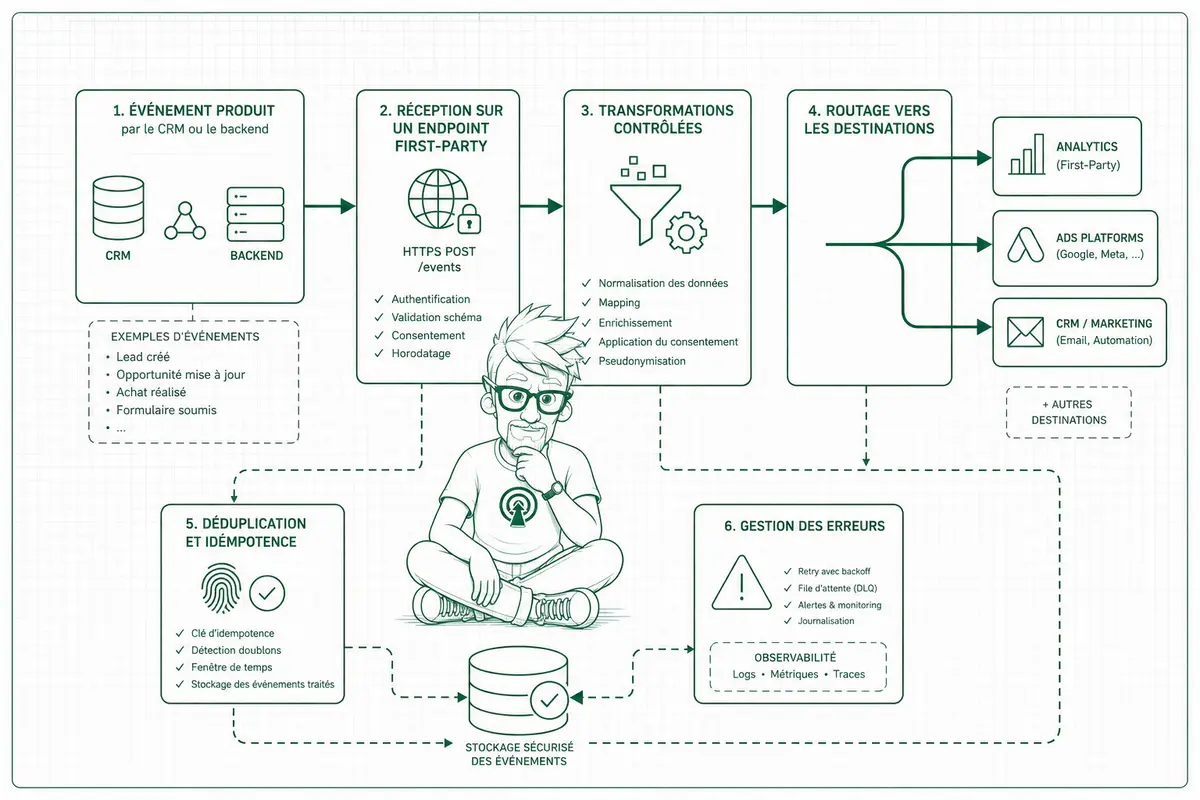
Je configure uniquement les clients et les balises nécessaires à chaque destination. Un client reçoit les données entrantes et les interprète ; une balise les transmet au système cible. La sélection minimale réduit les doublons, les transferts inutiles et les risques d’envoyer des données non prévues.
Les transformations servent à mettre les champs au même format, à supprimer ceux qui ne sont pas requis ou à limiter leur contenu avant transmission. Je conserve toutefois les identifiants de corrélation, comme l’identifiant d’événement ou de transaction, pour rapprocher les interactions entre le CRM, l’analytics et les Ads. Je préserve aussi l’état du consentement : une donnée ne doit pas être transmise en contradiction avec les choix de la personne.
Pour les données CRM ou backend, le traitement doit être idempotent. Autrement dit, recevoir plusieurs fois le même événement ne doit pas créer plusieurs conversions ou mises à jour. Je m’appuie sur un identifiant stable permettant de reconnaître un événement déjà traité.
La gestion des erreurs doit être explicite, pas silencieuse. Je distingue les erreurs temporaires, qui peuvent justifier une nouvelle tentative, des erreurs définitives, qui nécessitent une correction des données ou de la configuration. Je journalise le résultat du traitement sans exposer inutilement de données personnelles.
Le flux reste lisible et vérifiable :
- Le CRM ou le backend produit un événement avec ses identifiants de corrélation et son état de consentement.
- Le point de terminaison first-party reçoit l’événement et applique les transformations autorisées.
- Les seuls clients et balises requis transmettent les champs permis vers l’analytics ou les Ads.
- Le système contrôle les doublons et traite explicitement les échecs.
Je valide enfin chaque destination séparément. Une transmission réussie vers l’analytics ne garantit pas que la plateforme Ads a accepté l’événement.
Comment valider le déploiement et prévoir le retour arrière ?
Je valide le déploiement sur un périmètre limité : un événement CRM, une audience ou un flux de conversion, avec un résultat attendu défini avant activation. Un responsable nominativement identifié valide les preuves et autorise le passage en production.
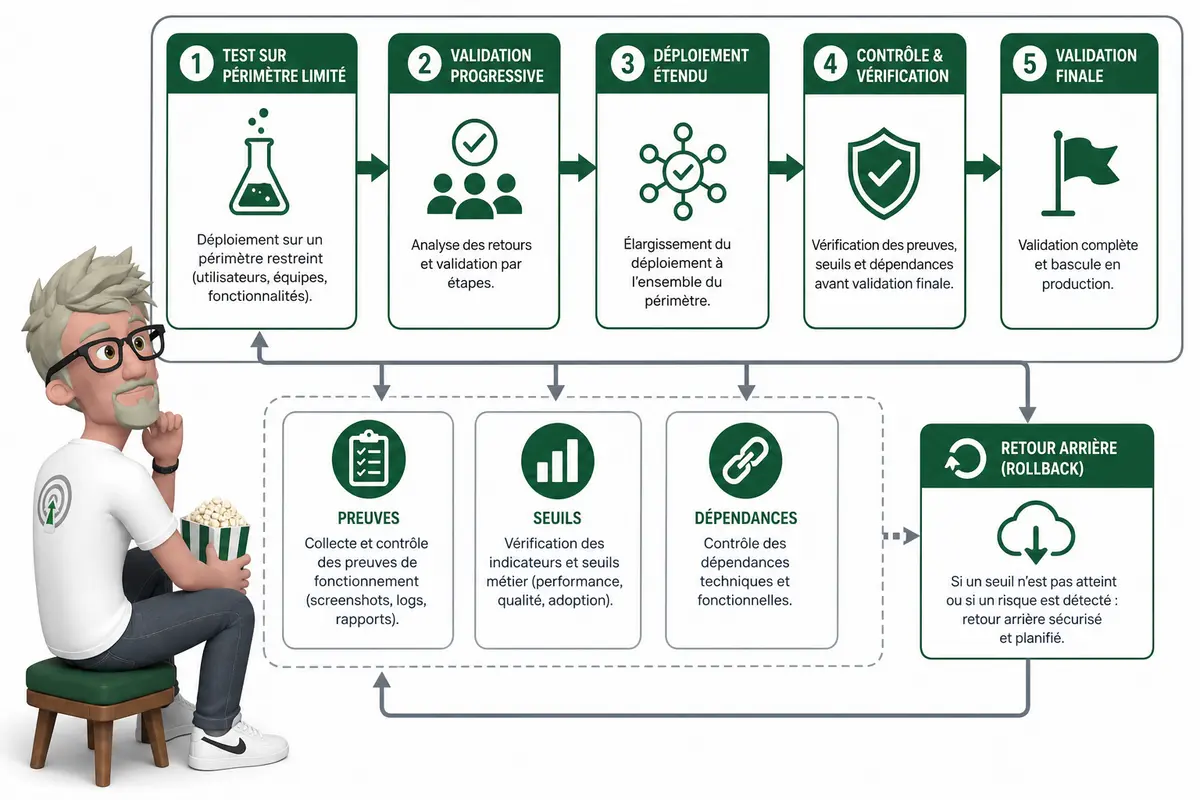
Pour le cas CRM vers analytics et Ads, je contrôle les enregistrements transmis, les champs autorisés, les identifiants de rapprochement, la devise, les horodatages et le statut de consentement. Je vérifie aussi qu’aucune donnée interdite ou inutile n’est exportée. Les preuves doivent être consultables et datées : journal d’envoi, échantillon anonymisé, compteurs côté source et destination, erreurs et doublons.
Je compare les résultats à une référence datée, prise avant le déploiement : volumes, taux de correspondance des identifiants, conversions attribuées et écarts de valeur. Les seuils d’acceptation sont écrits à l’avance. Un contrôle réussi signifie que les données attendues arrivent une seule fois, avec les bons champs et sans perte de consentement — pas seulement que l’intégration répond sans erreur.
Avant activation, je vérifie les dépendances en amont, notamment les champs CRM, les règles de consentement et la qualité des identifiants. En aval, je contrôle les connecteurs analytics, les audiences Ads, les rapports et les mécanismes d’enchères qui consomment ces données.
Le retour arrière doit être exécutable sans improvisation : désactiver le flux ou le feature flag, rétablir le mapping précédent, suspendre les audiences ou conversions affectées, puis vérifier l’arrêt des envois. Je documente qui l’exécute, le délai maximal et les critères de déclenchement. Après rollback, je rapproche les volumes et confirme qu’aucune donnée erronée ne continue à alimenter les plateformes.
- Le périmètre, le résultat attendu et les seuils sont définis.
- Le responsable de validation et l’opérateur du retour arrière sont identifiés.
- Les enregistrements, champs, identifiants, devises, horodatages et consentements sont contrôlés.
- Les résultats sont comparés à une référence datée, avec des preuves vérifiables.
- Les dépendances en amont et en aval sont vérifiées.
- La procédure de retour arrière a été testée et ses critères de déclenchement sont documentés.
Votre flux CRM est-il prêt à être activé ?
Relier les résultats CRM à l’analytics et aux Ads demande d’abord de définir les événements commerciaux et les transitions à suivre. La cartographie des champs clarifie leur source, leur destination et les responsabilités. Les identifiants approuvés, les horodatages, la devise et les valeurs doivent être vérifiés de bout en bout, sans reconstruire les données manquantes. Un point de terminaison first-party, des transformations ciblées, le respect du consentement, l’idempotence et une gestion explicite des erreurs structurent le transfert. Enfin, une référence datée, des preuves et un retour arrière rendent le changement contrôlable. Vous obtenez ainsi un flux plus fiable, limité aux données nécessaires et plus facile à auditer.
FAQ
-
Pourquoi relier les résultats CRM à l’analytics et aux Ads ?
Pour rapprocher l’activité du site de la valeur commerciale, en transmettant des événements CRM définis et des identifiants de corrélation autorisés. -
Quels éléments faut-il définir avant l’intégration ?
Les événements commerciaux, les étapes et transitions du cycle de vie, les champs concernés, les sources faisant autorité, les responsabilités et les preuves attendues. Il faut aussi établir une référence datée de l’existant. -
Comment préserver le contexte d’attribution ?
En capturant les identifiants de clic ou de corrélation approuvés et en les conservant dans le flux. Une donnée manquante ne doit pas être reconstruite à partir d’éléments de présentation. -
Quelles données faut-il vérifier avant leur transmission ?
Les noms, types, portée, temporalité, identifiants, horodatages, devise, valeurs et champs vides. Il faut également appliquer la minimisation des données et préserver l’état du consentement. -
Comment limiter les risques lors du déploiement ?
En testant sur un périmètre restreint, en modifiant une seule couche logique à la fois, en documentant les preuves et les responsables, puis en prévoyant une procédure de retour arrière et une gestion explicite des erreurs.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans la conception de flux de données documentés, contrôlables et alignés sur leurs objectifs métier.

⭐ Expert et formateur en Tracking avancé, Analytics Engineering et Automatisation IA (n8n, Make) ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.