


Oui, il en existe. GrowthBook en auto-hébergement, PostHog, Statsig et Firebase A/B Testing permettent de lancer de vrais tests, avec un moteur statistique sérieux et sans licence. Mais le prix n’a jamais été le facteur limitant. Ce qui rend un test fiable, c’est le protocole : taille d’échantillon fixée à l’avance, durée décidée avant le lancement, une seule métrique de décision, et personne qui regarde le tableau de bord toutes les deux heures. Sur ce terrain, un outil gratuit se comporte exactement comme un outil payant. Il calcule une significativité. Il ne vous protège pas de vous-même.
Que reste-t-il du test A/B gratuit après la fin de Google Optimize ?
Il ne reste plus de solution gratuite universelle côté éditeur, et le vide a été comblé par l’open source et les offres freemium facturées à l’usage. Google Optimize et Optimize 360 ne sont plus disponibles depuis le 30 septembre 2023. Google a fermé le service et redirigé vers des intégrations tierces avec Google Analytics 4, en citant nommément AB Tasty, Optimizely et VWO (Google, 2023). GA4 n’embarque pas de moteur de test : il expose des événements, pas des variantes.
Concrètement, l’éditeur qui offrait un éditeur visuel gratuit à tout le monde a transféré la charge vers des acteurs commerciaux. Les trois partenaires cités par Google vendent sur devis ou au volume d’utilisateurs actifs. Ceux qui ne veulent pas payer se sont donc tournés vers deux familles : les plateformes open source qu’on héberge soi-même, et les plateformes produit qui offrent un quota mensuel généreux en espérant vous facturer le dépassement.
Ce basculement a une conséquence technique que je vois mal documentée. Avec Optimize, l’expérience était une couche posée sur la page. Avec GrowthBook ou PostHog, l’expérience devient du code, un feature flag évalué côté serveur ou côté client. Le test cesse d’être un outil marketing et devient une brique du produit. Ce n’est pas neutre : il faut un développeur dans la boucle, et c’est souvent là que le projet s’arrête, pas sur le prix.
Quels outils de test A/B sont réellement gratuits en 2026 ?
Quatre familles tiennent la promesse, chacune avec une limite explicite qu’il faut lire avant de s’engager.
L’open source que vous hébergez vous-même
GrowthBook est le seul de la sélection dont le cœur est publié sous licence MIT et dont l’auto-hébergement est réellement supporté. Un docker compose up, et vous avez un moteur d’expérimentation complet : 24 SDK, évaluation locale des flags, moteur statistique avec CUPED, tests séquentiels, bayésien, post-stratification, bandits et détection de SRM (growthbook/growthbook). Gratuit, utilisateurs illimités, données chez vous.
Leur offre Cloud gratuite est plus étroite mais suffisante pour démarrer : 3 utilisateurs, 1 projet, expériences et trafic illimités. Au-delà, c’est 40 $ par siège et par mois (growthbook.io/pricing). Attention au mot « open source » : GrowthBook est un modèle open core, certains répertoires relèvent d’une licence commerciale.
Les offres freemium facturées à l’usage
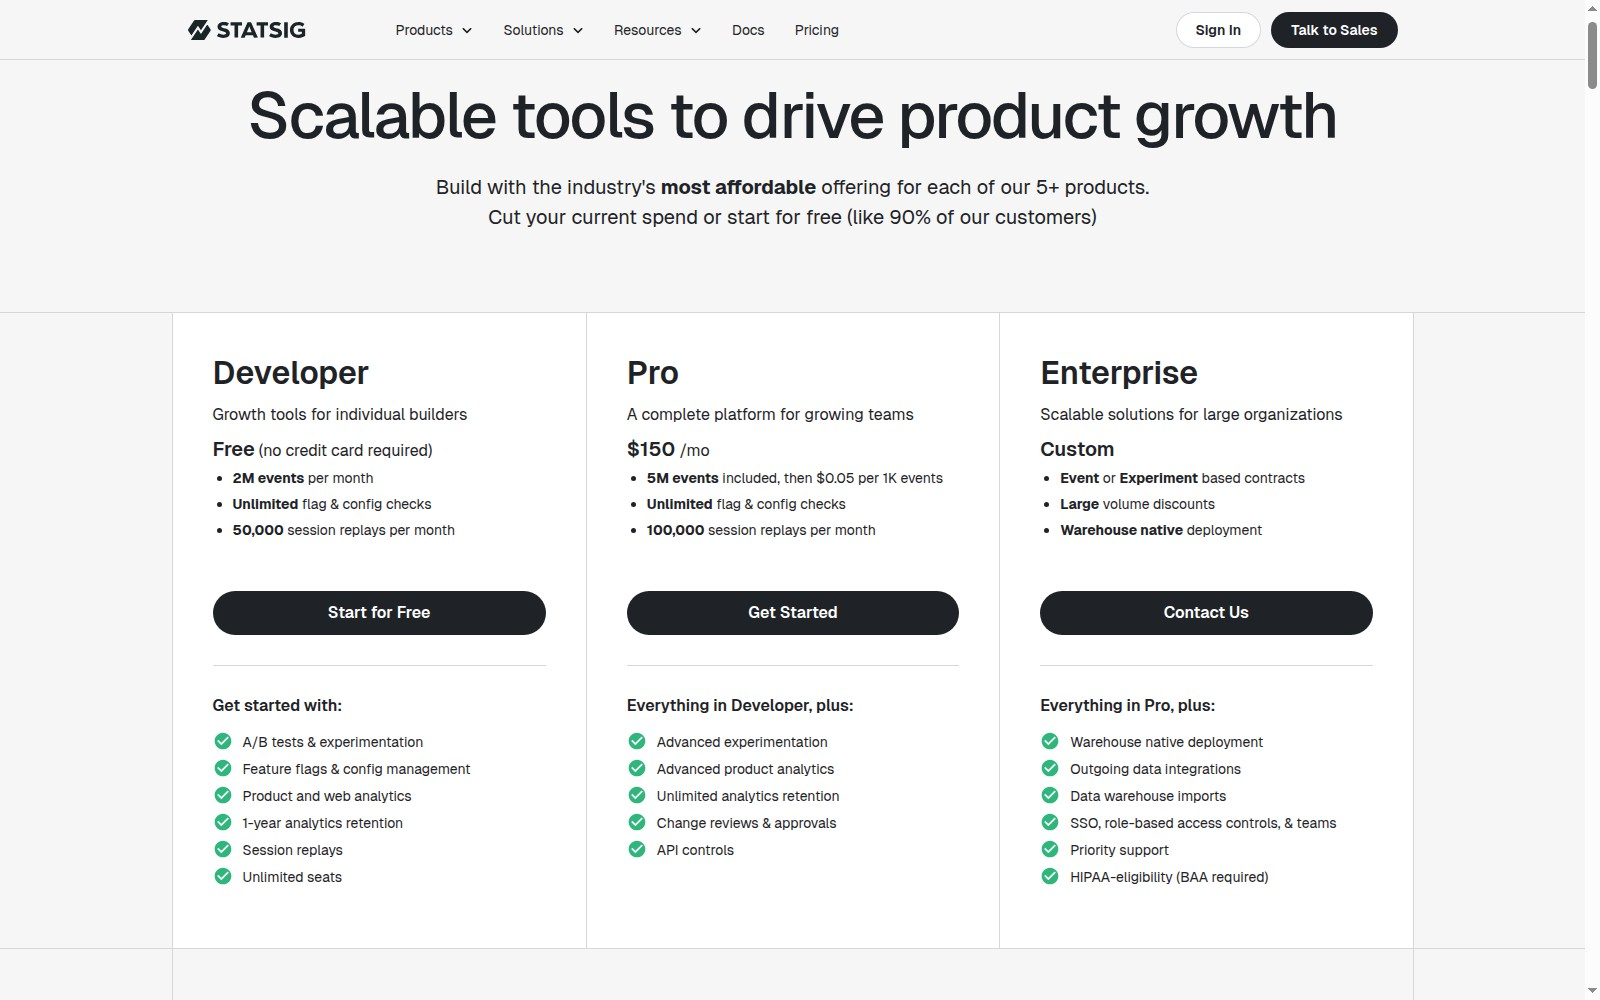
PostHog et Statsig offrent des quotas mensuels qui couvrent largement un site de taille moyenne. PostHog inclut 1 million de requêtes de feature flags par mois, et facture les expériences avec ces mêmes flags. Leur argument commercial est explicite : 97 % de leurs clients resteraient sur le gratuit, avec une limite de facturation paramétrable pour éviter la surprise (posthog.com/pricing). Statsig donne 2 millions d’événements par mois, sièges illimités, avant de passer à 150 $/mois (statsig.com/pricing).
Les deux ont un avantage décisif sur un outil de test pur : la donnée comportementale est dans le même produit. Quand une variante gagne, vous ouvrez le replay de session de cette variante et vous comprenez pourquoi. Sur un projet CRO, ça vaut plus que la licence.
Firebase A/B Testing, pour les applications mobiles
Firebase A/B Testing est annoncé sans coût sur la grille Firebase, et Remote Config inclut 100 000 requêtes de fetch par jour sur le plan Spark gratuit, avec l’intégration A/B Testing dans les deux plans (firebase.google.com/pricing). Depuis le 23 octobre 2023, les nouveaux tests utilisent une inférence fréquentiste et ne dépendent plus de l’infrastructure Optimize.
C’est la seule option crédible si votre expérience se joue dans une app iOS ou Android : Remote Config modifie le comportement sans republier de version, et l’analyse s’appuie sur Google Analytics. Sur le web, en revanche, l’outil est nettement moins souple qu’un GrowthBook.
Les faux gratuits
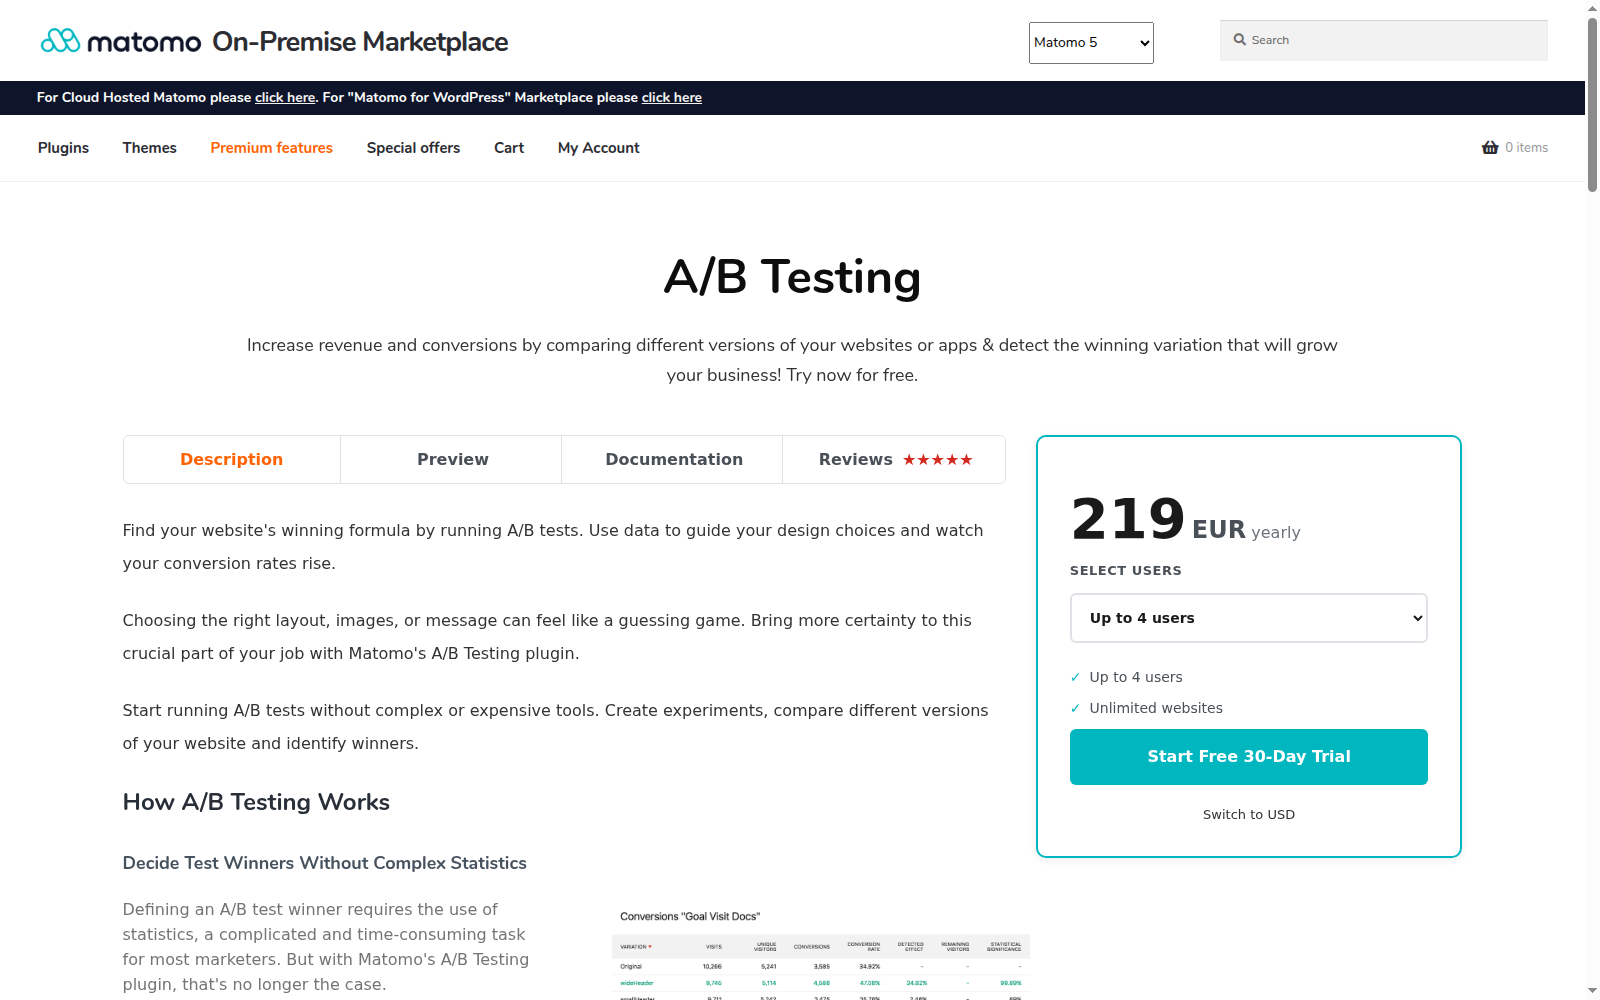
Matomo est souvent cité comme « l’alternative gratuite ». Le cœur analytics l’est. Le test A/B, non : c’est un plugin premium, en essai 30 jours puis 219 €/an jusqu’à 4 utilisateurs, sites illimités (plugins.matomo.org/AbTesting). Le calcul est rapide : à ce prix, vous payez surtout l’hébergement des données en Europe et l’absence de dépendance à un éditeur américain, pas le moteur statistique.
| Outil | Gratuit jusqu’où | Modèle | Au-delà |
|---|---|---|---|
| GrowthBook auto-hébergé | Illimité (utilisateurs, expériences, trafic) | Cœur MIT, open core | Support et fonctions entreprise |
| GrowthBook Cloud | 3 utilisateurs, 1 projet | Freemium | 40 $/siège/mois |
| PostHog | 1 M requêtes de flags/mois, 1 M événements | Usage | ~0,0001 $/requête |
| Statsig | 2 M événements/mois, sièges illimités | Usage | 150 $/mois |
| Firebase A/B Testing | Sans coût, 100 000 fetch Remote Config/jour | Intégré à Firebase | Facturation au-delà du quota |
| Matomo A/B Testing | Essai 30 jours | Plugin premium | 219 €/an (4 utilisateurs) |
Un outil gratuit est-il un outil fiable ?
Non, pas par nature. Un outil gratuit n’est pas moins fiable qu’un outil payant, mais aucun des deux ne vous rend fiable. La différence se joue sur trois points : le moteur statistique, la qualité des données injectées, et la discipline d’arrêt.
Le premier piège est le péage de résultat. Si vous regardez le tableau de bord en continu et arrêtez au premier badge vert, les niveaux de significativité affichés deviennent faux. Evan Miller l’a chiffré en 2010 : dans un scénario où A et B sont identiques, un test consulté après chaque observation et arrêté au premier résultat significatif produit 26,1 % de faux positifs au lieu des 5 % annoncés (Miller, 2010). Dix consultations suffisent à transformer un p affiché de 1 % en un vrai 5 %.
Le deuxième piège est le taux de base. À Microsoft, sur des expériences bien conçues et bien exécutées, environ un tiers seulement amélioraient la métrique qu’elles visaient (Kohavi et al., 2010). Autrement dit : la plupart de vos idées sont mauvaises, et vous ne le savez pas à l’avance. Statistiquement, cela change tout. Quand la probabilité qu’un effet réel existe est faible, un p à 0,05 reste très probablement un faux positif — c’est l’argument bayésien développé par les mêmes auteurs (Kohavi, Deng et Xu, 2014).
Le troisième piège est l’ampleur réelle des gains. Toujours chez Bing, les expériences qui réussissent améliorent les métriques clés de 0,1 % à 1,0 % une fois l’effet dilué sur l’ensemble du trafic. Pas 15 %. Pas 40 %. Ce n’est pas un détail de présentation : c’est ce qui détermine la taille d’échantillon nécessaire, donc la faisabilité du test.
À cela s’ajoute l’instrumentation. Un décalage de répartition entre variantes, un cache qui sert l’ancienne version à une partie des visiteurs, un événement de conversion déclenché deux fois : le test est mort avant d’avoir commencé. Sur un projet e-commerce, je vérifie toujours le tracking avant de lancer quoi que ce soit — c’est la même discipline que pour fiabiliser le tracking WooCommerce dans GA4.
Un moteur statistique de qualité sur des données fausses produit une réponse fausse, avec une belle courbe de confiance.
Combien de trafic faut-il pour qu’un test A/B veuille dire quelque chose ?
C’est la vraie question, et elle se calcule avant de choisir un outil. La taille d’échantillon dépend de trois paramètres : le taux de conversion de départ, l’effet relatif que vous voulez détecter, et le risque d’erreur que vous acceptez.
Prenons les conventions usuelles : risque alpha de 5 % bilatéral, puissance de 80 %. Le tableau ci-dessous donne le nombre de visiteurs nécessaires par variante.
| Taux de conversion de départ | Effet à détecter | Visiteurs par variante | Total | Durée à 1 000 visites/jour |
|---|---|---|---|---|
| 1 % | +20 % | 42 691 | 85 382 | 85 jours |
| 3 % | +20 % | 13 911 | 27 822 | 28 jours |
| 3 % | +10 % | 53 208 | 106 416 | 106 jours |
| 5 % | +10 % | 31 231 | 62 462 | 62 jours |
| 10 % | +20 % | 3 839 | 7 678 | 8 jours |
Calculs personnels : formule standard d’échantillonnage pour deux proportions (alpha = 0,05 bilatéral, puissance = 80 %).
Lisez la troisième ligne. Un site e-commerce à 3 % de conversion qui veut détecter une amélioration de 10 % — passer de 3,00 % à 3,30 % — a besoin de 53 208 visiteurs par variante. À 1 000 visites par jour, cela fait 106 jours. Trois mois et demi pour un seul test, en supposant que rien ne bouge pendant ce temps : pas de campagne, pas de soldes, pas de changement de saison.
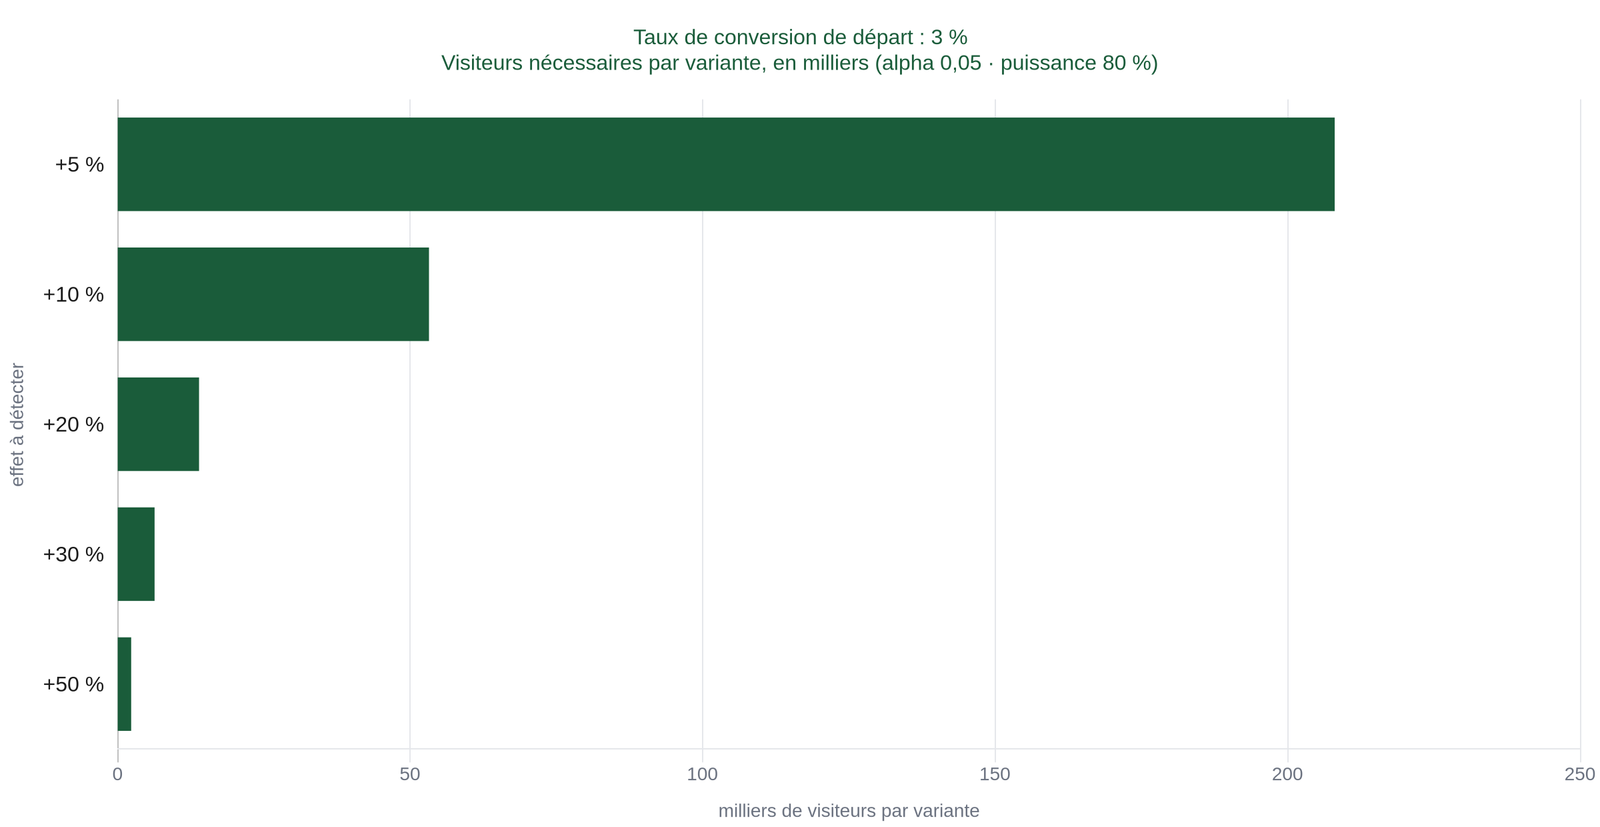
C’est pour cela que je refuse de lancer des tests sur des sites à faible trafic. Pas par principe, par arithmétique. Un test sous-dimensionné ne prouve rien : il produit du bruit, et ce bruit est ensuite brandi en réunion comme un résultat. Un client m’a montré l’an dernier trois tests lancés sur 4 000 visites mensuelles, avec des conclusions tranchées sur chacun. Aucun n’avait la puissance nécessaire pour détecter autre chose qu’un bouleversement à +50 %. Les décisions prises sur ces chiffres étaient des paris habillés en science.
Quand le volume manque, il reste trois voies honnêtes. Réduire la variance plutôt que le seuil : CUPED et les tests séquentiels servent exactement à ça, et ils sont disponibles dans GrowthBook. Augmenter l’effet testé : ne tester que des changements radicaux, où un +30 % est plausible. Ou renoncer au test et travailler en qualitatif — replays de session, analyse des micro-conversions, entretiens. Ce n’est pas un aveu de faiblesse, c’est un choix de méthode.
Comment choisir son outil selon votre volume de trafic ?
La réponse tient en une règle : l’outil doit suivre votre volume, pas l’inverse. Voici comment je tranche concrètement.
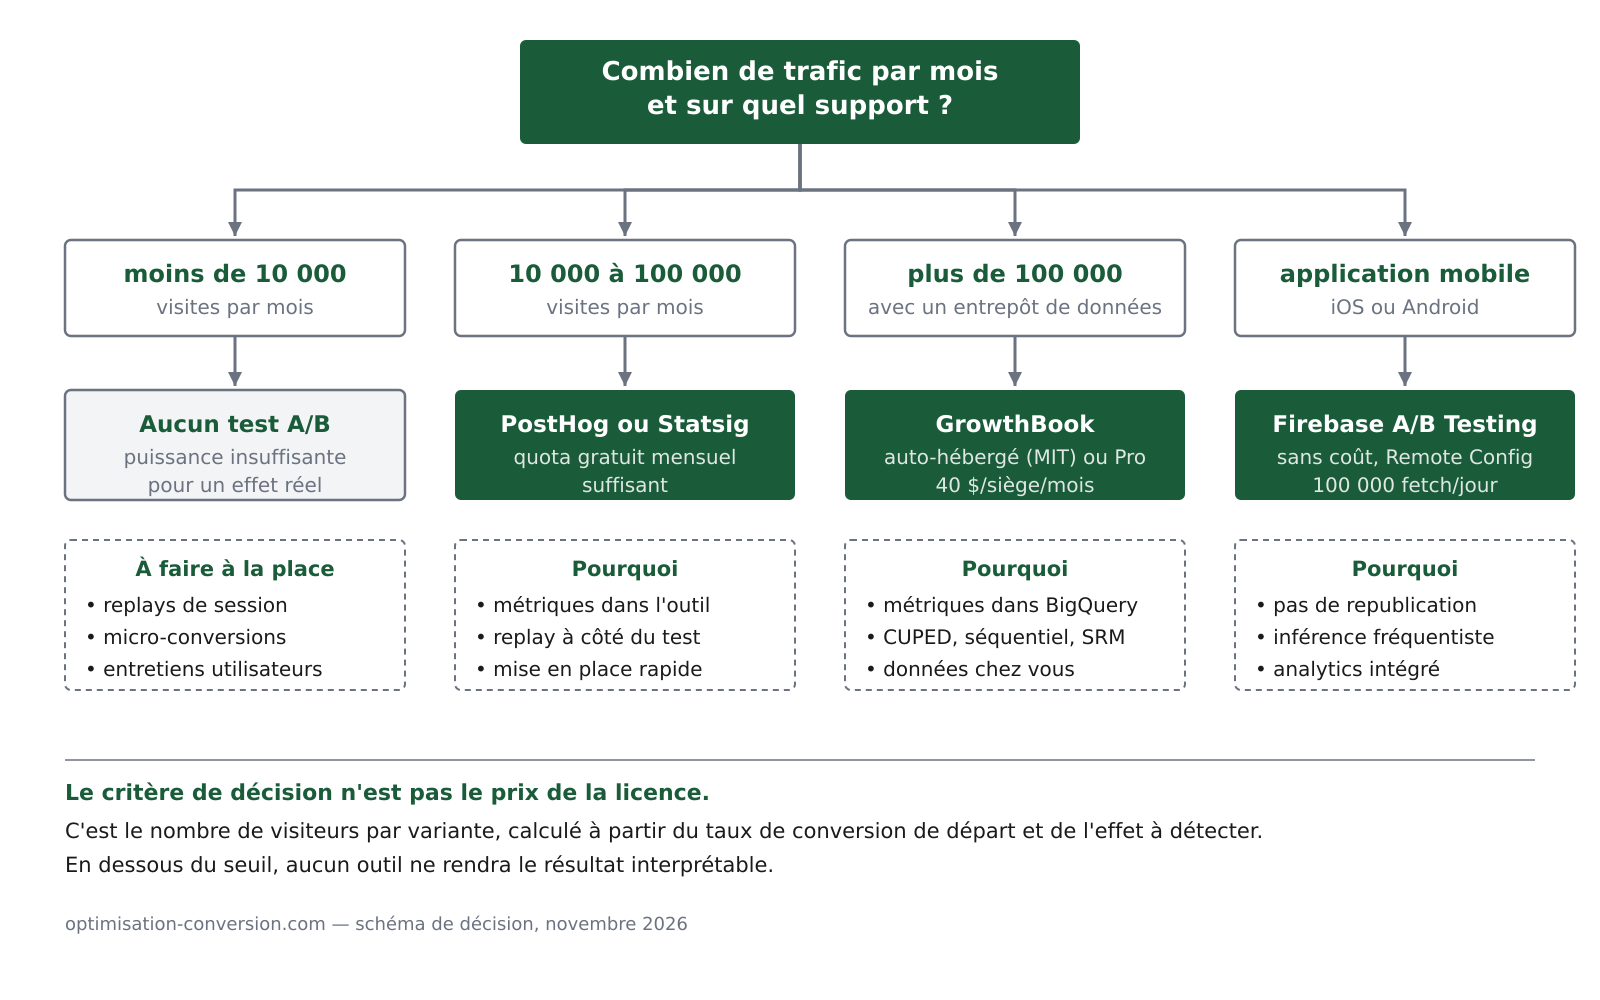
- Moins de 10 000 visites par mois. Aucun outil ne vous sauvera. Comptez ce que vous pouvez réellement détecter : à 5 000 visites par mois sur une base de 3 %, il faut viser un effet de +50 % pour espérer une conclusion en un trimestre. Utilisez le gratuit pour ce qu’il fait bien : replays de session (5 000 par mois chez PostHog), micro-conversions, analyses de parcours.
- 10 000 à 100 000 visites par mois. PostHog ou Statsig en gratuit. Mise en place rapide, pas d’entrepôt à connecter, un seul SDK. Vous gardez la donnée comportementale à côté du test, ce qui est le vrai gain.
- Plus de 100 000 visites et un entrepôt de données. GrowthBook, auto-hébergé ou en Pro. Vos métriques restent définies là où elles vivent déjà — BigQuery, Snowflake, ClickHouse — et vous arrêtez de maintenir deux définitions de la conversion. Le test devient cohérent avec le reste du reporting, ce qui rejoint le débat analytics tout-en-un ou stack connectée.
- Application mobile. Firebase A/B Testing, sans hésiter. Remote Config évite les cycles de validation des stores.
- Contrainte de souveraineté ou données sensibles. GrowthBook auto-hébergé, ou Matomo avec le plugin payant. Vous perdez en confort, vous gagnez en maîtrise.
Sur ce dernier point, je suis catégorique : si votre DPO ou votre client final interdit l’envoi de données comportementales à un tiers, la question du prix devient secondaire. L’auto-hébergement de GrowthBook sur un VPS coûte moins de 20 € par mois et met la donnée sous votre contrôle.
Le gratuit est-il vraiment le problème ?
Non. Le gratuit a résolu la question du coût d’entrée, et c’est un progrès réel : en 2020, lancer un programme de test sérieux demandait un budget annuel à quatre chiffres. Aujourd’hui, la licence est le poste le moins cher du dispositif.
Les coûts qui restent sont ailleurs. Il faut instrumenter proprement, donc du temps d’ingénieur. Il faut du trafic, et ça ne s’achète pas au mois. Il faut accepter de perdre deux tests sur trois sans rien livrer. Et il faut tenir la discipline d’arrêt quand le badge passe au vert le mardi matin.
Mon conseil, si vous démarrez : prenez un outil gratuit, mais écrivez la taille d’échantillon et la date de fin avant de lancer. Si vous ne pouvez pas remplir ces deux cases, vous n’avez pas besoin d’un outil. Vous avez besoin de travailler le taux de conversion autrement — sur les points de friction, les micro-conversions et la qualité du parcours, là où les erreurs CRO coûtent vraiment des ventes.
Questions fréquentes sur les tests A/B
-
Existe-t-il un outil de test A/B totalement gratuit ?
Oui. GrowthBook auto-hébergé est gratuit sans limite d’utilisateurs ni d’expériences, avec un cœur sous licence MIT. Firebase A/B Testing est annoncé sans coût, avec un quota de 100 000 requêtes Remote Config par jour. PostHog et Statsig sont gratuits dans la limite d’un quota mensuel. -
Un outil gratuit est-il moins fiable qu’un outil payant ?
Non. La fiabilité vient du protocole, pas de la facture : taille d’échantillon fixée à l’avance, durée décidée avant le lancement, pas d’arrêt sur un pic. Un test payant mal conduit produit exactement les mêmes faux positifs. -
Peut-on faire un test A/B sans outil dédié ?
Oui, avec un feature flag maison et un calcul de significativité hors plateforme. C’est faisable, mais vous perdez le contrôle du SRM, l’analyse par segment et l’historique. Pour un test ponctuel, c’est acceptable. Pour une pratique régulière, non. -
Pourquoi Google Optimize a-t-il fermé ?
Google a invoqué un manque de fonctionnalités attendues par ses clients et annoncé un recentrage sur les intégrations tierces de Google Analytics 4, en citant AB Tasty, Optimizely et VWO. Le service a fermé le 30 septembre 2023. -
Combien de temps doit durer un test A/B ?
La durée se calcule avant le lancement, à partir du nombre de visiteurs nécessaires par variante. Elle doit couvrir au moins un cycle d’activité complet, une semaine minimum, pour lisser l’effet jour de semaine. Arrêter dès qu’un résultat devient significatif invalide la conclusion.
À propos de l’auteur
Franck Scandolera — data engineer et spécialiste de la performance digitale. Je mesure, je teste et j’automatise les dispositifs d’optimisation de conversion : instrumentation analytics, expérimentation produit, décision sur données fiables. Je travaille avec des équipes e-commerce et B2B qui veulent arrêter de choisir leurs variantes à l’intuition.
Sources
- Google, « [Sunset September 2023] Google Optimize », Google Analytics Help, 2023. https://support.google.com/optimize/answer/12919339?hl=en
- R. Kohavi, A. Deng, Y. Xu, « Seven Rules of Thumb for Web Site Experimenters », KDD 2014. https://www.exp-platform.com/Documents/2014%20experimentersRulesOfThumb.pdf
- R. Kohavi et al., « Online Experimentation at Microsoft », 2010. https://exp-platform.com/Documents/ExP_DMCaseStudies.pdf
- E. Miller, « How Not To Run an A/B Test », 18 avril 2010. https://www.evanmiller.org/how-not-to-run-an-ab-test.html
- GrowthBook, « Open Source Feature Flags, Experimentation, and Product Analytics », dépôt GitHub et page pricing, consultés le 8 novembre 2026. https://github.com/growthbook/growthbook · https://www.growthbook.io/pricing
- PostHog, « Pricing », consulté le 8 novembre 2026. https://posthog.com/pricing
- Statsig, « Pricing », consulté le 8 novembre 2026. https://www.statsig.com/pricing
- Firebase, *Pricing* et « A/B Testing », consultés le 8 novembre 2026. https://firebase.google.com/pricing/ · https://firebase.google.com/docs/ab-testing
- Matomo Marketplace, « A/B Testing plugin », consulté le 8 novembre 2026. https://plugins.matomo.org/AbTesting

⭐ Expert et formateur en Tracking avancé, Analytics Engineering et Automatisation IA (n8n, Make) ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.